Prestaties
Lees in de console de prestatiegrafieken van hosts, virtuele machines en datastores, kies een periode en verzamel de samples met Prometheus.
Kyvernon bewaart prestatiesamples van hosts, virtuele machines en datastores in de controller, en de console tekent ze als grafieken op het tabblad van het object. De hostagents melden de samples elke 20 seconden, en de controller rolt ze op tot langere perioden.
In de console
Selecteer in de inventaris een host, een virtuele machine of een datastore en open het tabblad Bewaking.
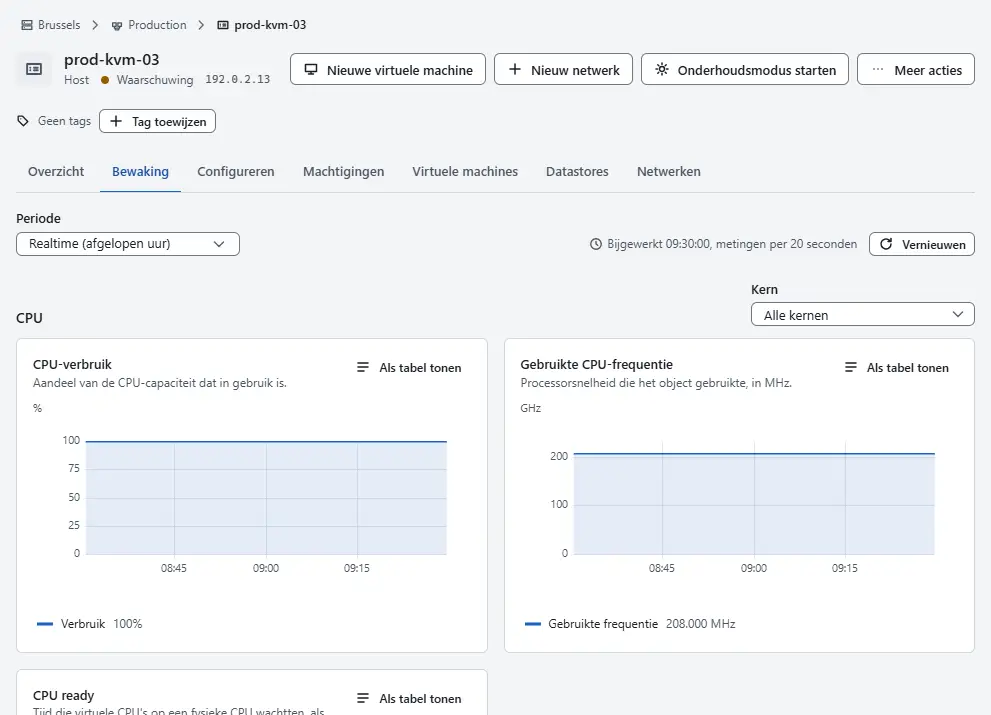
Kies de periode onder Periode. Elke periode heeft een eigen bemonstering en wordt beperkte tijd bewaard:
Periode Bemonstering Bewaard gedurende Realtime (afgelopen uur) 20 seconden 1 uur Afgelopen dag 5 minuten 1 dag Afgelopen week 30 minuten 7 dagen Afgelopen maand 2 uur 30 dagen Afgelopen jaar 1 dag 365 dagen - Kies voor een ander tijdvak Eigen periode, voer Van en Tot in en selecteer Periode tonen. De samples worden aan het bereik aangepast. Het einde moet na het begin liggen.
Lees de grafieken. Een virtuele machine heeft de secties CPU, Geheugen, Schijf en Netwerk, bijvoorbeeld CPU-verbruik, CPU ready, Schijflatentie en Verworpen pakketten. Een datastore heeft de secties Ruimte en Prestaties. Selecteer een reeks in de legenda om die te verbergen of te tonen.
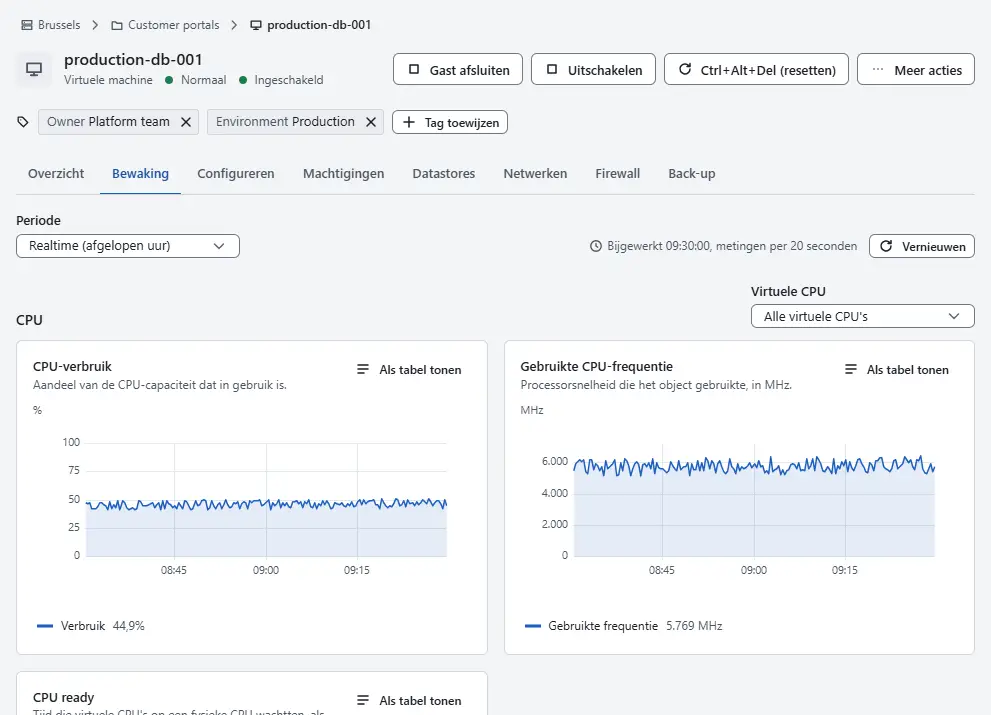
- Selecteer Als tabel tonen om de waarden te lezen met Minimum, Gemiddelde, Maximum en Laatste. Selecteer Vernieuwen om de grafieken opnieuw te lezen; de regel ernaast meldt wanneer ze voor het laatst zijn gelezen en met welke bemonstering.


Grafieken worden per host, virtuele machine en datastore bewaard. Een cluster, datacenter, map of netwerk toont geen eigen grafiek: open een van de leden. Een uitgeschakelde virtuele machine meldt geen samples, dus zijn grafieken tonen de perioden waarin hij draaide. Samples voor afzonderlijke cores, schijven en adapters worden bewaard voor de realtimeperiode.
Resultaat
De grafieken tonen de tellers van het object voor de gekozen periode. Een teller heeft een naam in de vorm group.name.rollup, bijvoorbeeld cpu.usage.average, en de groepen zijn cpu, mem, disk, net, datastore, virtualDisk, sys en rescpu. Verbruik rapporteert het verbruik uit dezelfde gegevens, en een alarm reageert op gebeurtenissen.
De beheerder bepaalt hoeveel er wordt bewaard via de sectie [metrics] van de controllerconfiguratie: of prestatiegegevens überhaupt worden bewaard, de grootte van het metricsbestand, hoe lang de grafieken van een verwijderd object blijven staan (standaard 7 dagen) en of samples naar een OpenTelemetry-endpoint worden gepusht. Er verlaat niets de controller tenzij dat is geconfigureerd. De sleutels staan in de configuratiereferentie.
Automatisering
Met de CLI
kyvernon metrics counters
kyvernon metrics available vm-42 --interval 300
kyvernon metrics query --entity vm-42 --counter cpu.usage.average --interval 300 --max-samples 12
--interval is de bemonsteringsperiode in seconden: 20, 300, 1800, 7200 of 86400. --entity en --counter nemen lijsten gescheiden door komma's. --instance is leeg voor het totaal, * voor alle instanties zoals elke schijf, of een enkele instantie. --start is exclusief en --end inclusief, beide in RFC 3339-notatie. Het antwoord is kolomgeoriënteerd, met timestamps en values per reeks, wat geschikt is voor het tekenen van grafieken.
Met de API
GET /v1/metrics/counters en GET /v1/metrics/intervals tonen de tellers en de perioden. GET /v1/metrics/entities/{id}/available?interval=<seconds> toont de tellers met gegevens voor een object. GET /v1/metrics/query geeft samples terug met entity, counter, interval, start, end, instance en maxSamples, en POST /v1/metrics/query neemt dezelfde parameters als JSON-body. Een query geeft gegevens terug voor de objecten die de aanroeper mag zien. Een query die geen object of teller noemt, te veel samples vraagt of een niet-ondersteunde periode gebruikt, mislukt met een bericht-id uit het gebied metrics; zie error.metrics_query_too_large.
Met Prometheus
GET /metrics/perf antwoordt in het tekstformaat van Prometheus met het nieuwste sample van elke reeks, voor de hosts, virtuele machines en datastores die het token mag zien. Elke metric heet kyvernon_perf_<group>_<name>_<unit>, bijvoorbeeld kyvernon_perf_cpu_usage_percent, en heeft de labels entity, entity_type, name en instance. Maak een API-token van een gebruiker met leestoegang en geef het aan Prometheus als bearer-referentie, met /metrics/perf als metricspad van de scrapejob en uw controlleradres als doel, bijvoorbeeld controller.example.com:8443. Een beheerder kan scrapes zonder token toestaan met de instelling anonymous in de sectie [metrics]; laat die uit tenzij het netwerk afgesloten is.
Zie ook
Versie 0.1. Laatst gewijzigd: 2026-11-14